Waarom je AI-zichtbaarheid wilt meten
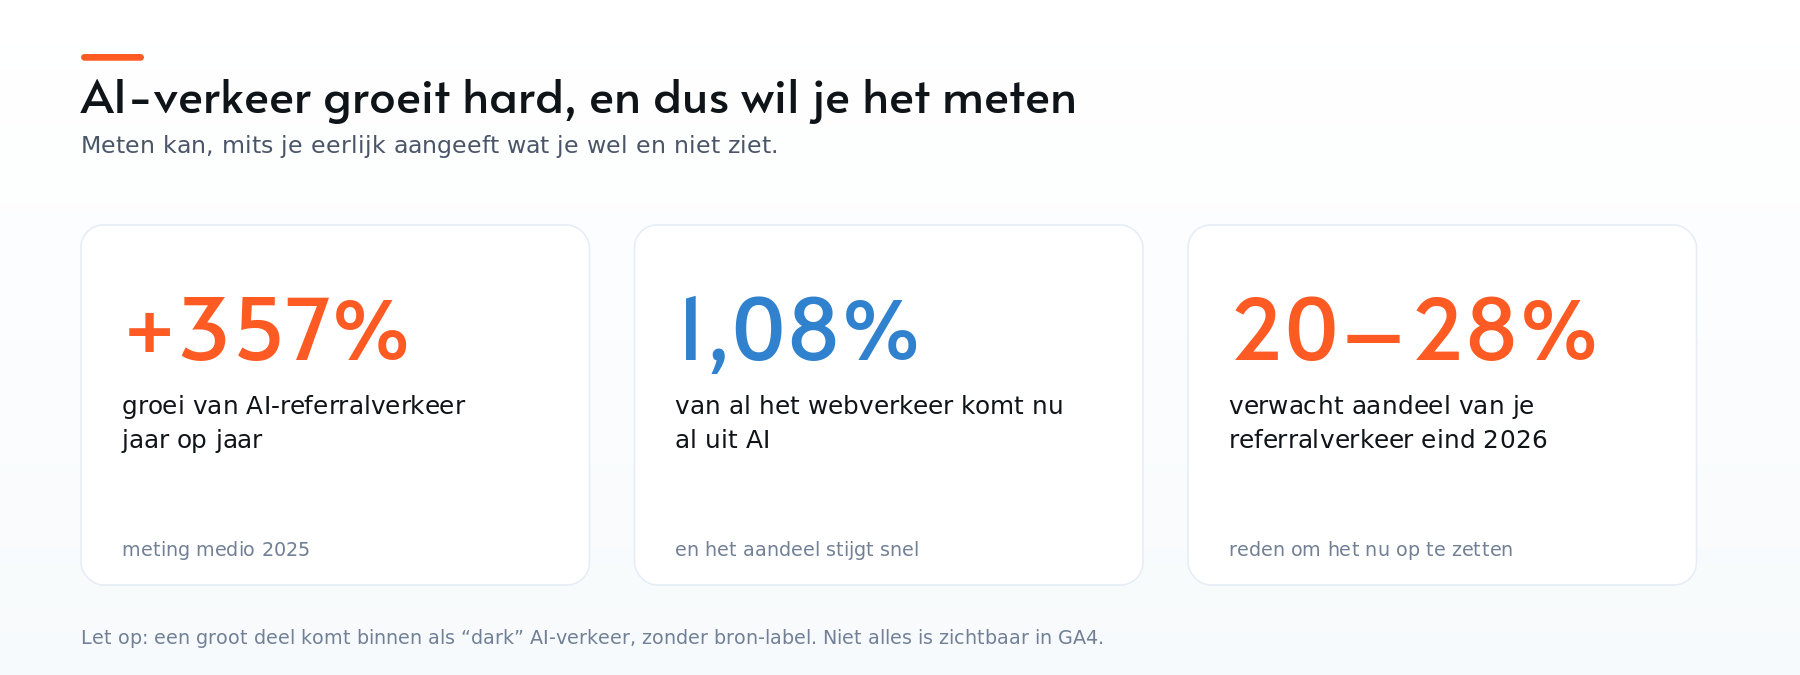
AI-verkeer groeit hard. Het aantal bezoekers dat via een AI-antwoord doorklikt nam medio 2025 met honderden procenten jaar op jaar toe, en al zo’n procent van het totale webverkeer komt inmiddels uit AI. De verwachting is dat AI eind 2026 een vijfde tot een kwart van je verwijzingsverkeer levert. Wat je niet meet, kun je niet sturen, dus je wilt weten of en hoe je in die antwoorden verschijnt.
Dit hoort bij generative engine optimization en sluit aan op onze aanpak voor Google AI Overviews en ChatGPT en Perplexity.
Vijf woorden die niet hetzelfde betekenen
Voordat je iets meet, moet helder zijn wat je meet. In gesprekken over AI-zichtbaarheid worden vijf begrippen door elkaar gebruikt, terwijl ze verschillende dingen betekenen. Dat is de eerste reden waarom rapportages elkaar tegenspreken.
- Zichtbaarheid. Hoe vaak je merk voorkomt in de AI-antwoorden die je gemeten hebt.
- Citation. Een AI-antwoord gebruikt jouw pagina expliciet als bron, met bronvermelding.
- Mention. Je merk wordt genoemd, maar zonder dat er naar je verwezen wordt.
- Crawlerhit. Een AI-crawler heeft je pagina daadwerkelijk opgehaald.
- Klik. Iemand komt via een AI-antwoord op je site terecht.
Een merk kan veel mentions hebben en nul citations. Of veel crawlerhits krijgen zonder ooit in een antwoord te verschijnen. Wie deze vijf op één hoop gooit, meet ruis.
Wat je wél en niet kunt meten
Eerlijk is eerlijk: een compleet overzicht zoals Search Console voor je zoekposities bestaat voor AI-antwoorden niet. AI-antwoorden zijn persoonlijk en niet openbaar terug te zoeken, dus je werkt met steekproeven en signalen, niet met een sluitende meetlat.
Er is ook een blinde vlek die dark AI traffic heet. In de praktijk ziet Google Analytics alleen de zichtbare verwijzingen die netjes een bron meesturen. AI Overview-klikken, Gemini, ChatGPT op mobiel en alle zero-click-interacties verdwijnen zonder label in je bestaande kanalen. Reken je jezelf daardoor niet arm of rijk, want een deel blijft onzichtbaar.
Waarde zonder klik
Dark traffic wordt vaak als meetprobleem gepresenteerd, maar er zit een groter punt onder. Een deel van je AI-zichtbaarheid levert helemaal geen klik op, en hoort dat ook niet te doen.
Stel dat iemand aan ChatGPT vraagt welk verhuisbedrijf betrouwbaar is. Het antwoord noemt drie partijen, legt de keuzecriteria uit en vermeldt waar je op moet letten. Word jij daarin genoemd als een van die drie, dan is er waarde ontstaan: je bent in beeld gekomen bij iemand die op het punt staat te kiezen. Die persoon hoeft niet door te klikken, want het antwoord staat er al.
Je klikcijfers onderschatten je zichtbaarheid dus stelselmatig. Niet door een meetfout, maar omdat de waarde ontstaat op een plek waar je meetinstrument niet komt. Wie AI alleen op sessies beoordeelt, concludeert te snel dat het niets oplevert.
De vijf databronnen, en wat elke bron niet laat zien
Er zijn vijf bronnen die iets zeggen over je AI-zichtbaarheid. Elke bron laat een ander stuk zien, en elke bron heeft een gat. Pas samen geven ze een bruikbaar beeld.
1. Google Search Console
Wat je ziet: klikken, vertoningen en posities in klassiek zoeken, en inmiddels ook een deel van de AI-zoekervaring. Wat je niet ziet: of, hoe vaak en waarom een AI-systeem diezelfde pagina raadpleegt.
2. GA4
Wat je ziet: gedrag, conversies en omzet op de site zelf. Wat je niet ziet: alles wat vóór de klik gebeurt, plus het hele deel dat zonder bron-label binnenkomt.
3. Prompttools voor AI-zichtbaarheid
Wat je ziet: of je merk terugkomt in antwoorden op een vaste set vragen, met sentiment en share of voice. Wat je niet ziet: een promptset is altijd een steekproef. Andere prompts geven andere uitkomsten, antwoorden zijn bovendien toegespitst op de gebruiker, en een vermelding bewijst niet dat je pagina echt is opgehaald.
4. Technische crawls
Wat je ziet: of een pagina op dit moment crawlbaar en leesbaar is voor een AI-systeem. Wat je niet ziet: het is een momentopname. Dat een pagina leesbaar is, zegt niets over hoe vaak hij daadwerkelijk wordt opgehaald.
5. Serverlogs
Wat je ziet: elke keer dat een AI-crawler een pagina echt ophaalt, met tijdstip en URL. Wat je niet ziet: waaróm die pagina is opgehaald, of hoe de inhoud in een antwoord is gebruikt.
De eerste vier zijn de bronnen waar de meeste bedrijven mee werken. De vijfde is degene die als enige harde werkelijkheid registreert, en die wordt het vaakst overgeslagen.
Serverlogs: de laag die de meeste bedrijven overslaan
Een serverlog legt elk verzoek aan je website vast, inclusief het verzoek van een AI-crawler. Je filtert op de user-agents die AI-systemen gebruiken en houdt over welke URL’s wanneer zijn opgehaald, en door wie.
Daarbij is één onderscheid belangrijk, omdat het bepaalt wat een hit betekent.
- User-initiated crawlers (ChatGPT-User, Claude-User, Perplexity-User) komen langs op het moment dat iemand een vraag stelt en het AI-systeem je pagina bezoekt om een antwoord te vormen. Een hit hier hangt samen met een concrete vraag van een echte gebruiker.
- Discovery- en trainingcrawlers (GPTBot, ClaudeBot, OAI-SearchBot, PerplexityBot) crawlen breed voor zoekindexering of modeltraining. Zo’n hit betekent alleen dat je domein wordt meegenomen in het bredere wereldbeeld van een model. Het zegt niets over een specifiek antwoord.
Dat verschil wordt in de praktijk vrijwel altijd door elkaar gehaald. Een piek in GPTBot-hits wordt gevierd als AI-zichtbaarheid, terwijl het iets anders betekent dan een piek in ChatGPT-User-hits. Allebei relevant, maar niet hetzelfde.
Serverlogs bewijzen niet alles. Ze zeggen niets over waarom een pagina is opgehaald of wat een model ermee deed. Maar het is het enige signaal in de rij dat geen steekproef en geen momentopname is.
Wat wij in serverlogs van klantsites terugzien
Eén patroon valt ons bij meerdere klantsites op, en het is niet wat je zou verwachten: AI-crawlers halen opvallend veel Engelstalige pagina’s op, ook bij sites die zich op de Nederlandse markt richten. Het gaat daarbij vooral om GPTBot, de crawler die voor indexering en modeltraining langskomt, en niet om ChatGPT-User.
Waar dit vandaan komt, kunnen we niet hard maken. Het is een observatie uit onze eigen logbestanden, geen onderzoeksresultaat. Wel scherpt het twee dingen aan. Ten eerste: de pagina’s die een model van je opneemt zijn niet per se de pagina’s waar jouw SEO-inspanning zit. Ten tweede: wie alleen naar Nederlandstalige prompts kijkt om zijn AI-zichtbaarheid te beoordelen, kijkt naar een klein stukje van wat er werkelijk gebeurt.
Het is precies het soort verband dat je nooit vindt in een prompttool of in GA4, en dat gewoon in een logbestand staat te wachten.
De cijfers die er echt toe doen
AI-zichtbaarheid vat je samen in een paar kernmaten. Samen geven ze een AI-zichtbaarheidsscore:
- Mention rate. Hoe vaak je merk voorkomt in AI-antwoorden op relevante vragen.
- Citation share. Of AI je aanhaalt als bron, dus of je als betrouwbaar wordt gezien.
- Share of voice. Hoe vaak jij verschijnt ten opzichte van je concurrenten op dezelfde vragen.
- Positionering. Hoe prominent je genoemd wordt: als eerste aanbeveling of als voetnoot.
- Sentiment. In welke toon je genoemd wordt, positief, neutraal of negatief.
Deze vijf komen uit prompttools en zijn dus steekproefcijfers. Zet ze naast je crawlerdata en je klikdata, niet in plaats daarvan.
Vijf niveaus om crawlerdata op te lezen
Ruwe crawlerdata per URL is onhandelbaar zodra je site meer dan een paar honderd pagina’s heeft. Je leest hem daarom op oplopende niveaus, en elk niveau beantwoordt een andere vraag.
- URL. Eén pagina, één signaal. Bruikbaar voor je belangrijkste pagina’s.
- Template. Een paginatype, zoals al je categoriepagina’s of al je plaatspagina’s. Hier wordt het interessant, want een patroon op templateniveau geldt meteen voor honderd pagina’s.
- Thema. Een cluster rond een onderwerp. Laat zien of een model je als bron ziet op een thema, of alleen op losse pagina’s.
- Website. Het hele domein in samenhang, inclusief homepage en sitemaps. Die niet-inhoudelijke pagina’s leveren geen contentkans op, maar zeggen wel iets over hoe een model je domein als geheel plaatst.
- Versus SEO-data. Hoe je crawlgedrag zich verhoudt tot je klassieke zoekverkeer.
Dat laatste niveau is waar de beslissingen vallen. Niet welke pagina je moet aanpassen, maar welk paginatype aandacht verdient.
Welke pagina’s verdienen voorrang
Zet je SEO-verkeer en je AI-crawlactiviteit naast elkaar, dan vallen je pagina’s in vier groepen. Elke groep heeft een eigen vervolgstap, en dat is precies waarom een universele GEO-checklist niet werkt.
- Veel SEO-verkeer, veel AI-crawls. Sterk in beide lagen. Analyseer waarom deze pagina werkt en gebruik hem als voorbeeld voor de rest.
- Weinig SEO-verkeer, veel AI-crawls. Een verborgen kans. AI vindt de inhoud relevant, je zoekverkeer blijft achter. Inhoud versterken en interne links verbeteren.
- Veel SEO-verkeer, weinig AI-crawls. Sterk in Google, zwak in AI. Controleer techniek en leesbaarheid, en herschrijf zodat elke alinea een zelfstandig antwoord geeft.
- Weinig SEO-verkeer, weinig AI-crawls. Lage prioriteit. Hier is iets fundamenteel mis, en dat rechtzetten kost veel werk. Alleen oppakken als de pagina strategisch belangrijk is.
Deel je pagina’s op templateniveau in, niet op siteniveau. Een gemiddelde over je hele site vertelt je niets, want de vier groepen bestaan naast elkaar binnen hetzelfde domein.
En eerlijk blijven over wat dit is: een prioriteringshulpmiddel, geen natuurwet. Er bestaat geen paginatype dat het altijd wint.
Zo brengen wij het samen in je dashboard
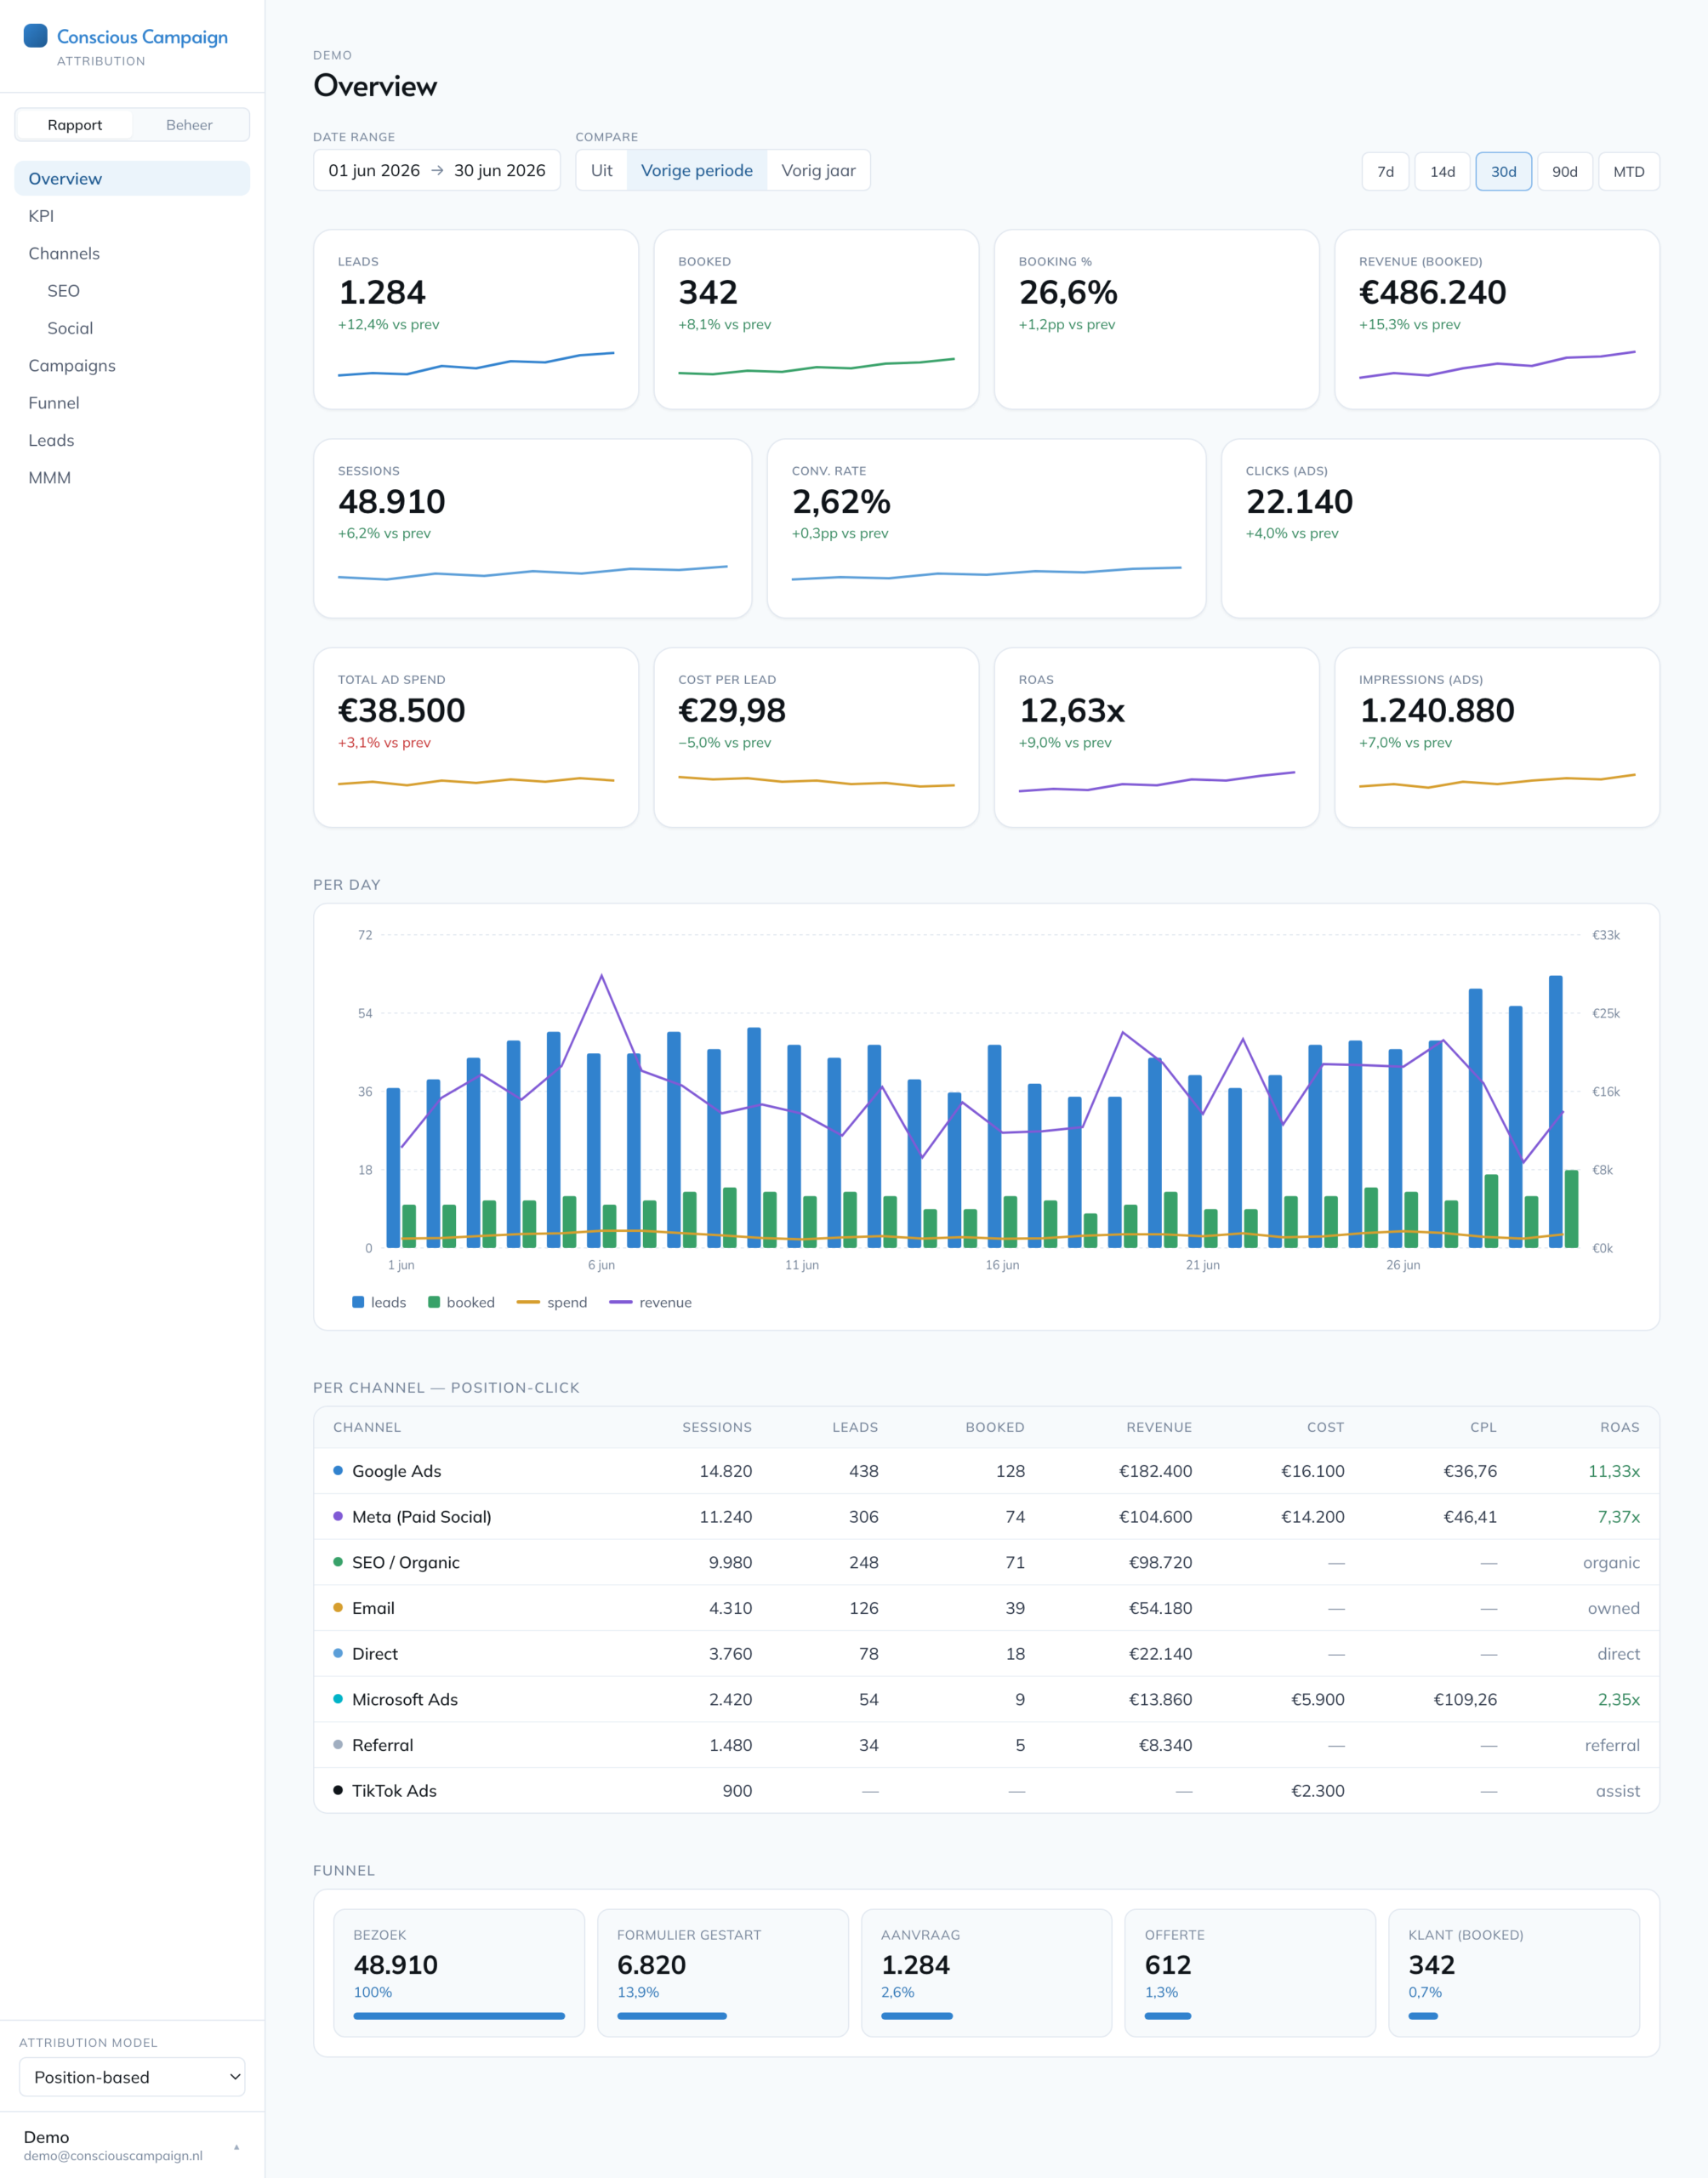
Losse tools en een GA4-rapport geven versnipperde signalen. Wij brengen je AI-zichtbaarheid en je AI-verkeer samen met je overige kanalen in het marketing dashboard, en koppelen het aan wat het echt oplevert: leads en omzet uit je CRM.
Voor het labelen van AI-verkeer kijken we naar twee dingen tegelijk: de referrer en de user-agent. Dat is bewust, want alleen op referrer filteren laat een deel liggen. Alle AI-platformen die we kennen komen als aparte bron terug, dus ChatGPT, Claude en Perplexity staan los van elkaar in beeld in plaats van samen in één verzamelbak AI.
Daarnaast splitsen we AI-verkeer in betaald en organisch. Betaald AI-verkeer, bijvoorbeeld uit ChatGPT Ads, herkennen we aan de UTM-parameters. Dat onderscheid wordt snel belangrijk: zonder die splitsing lijkt een advertentiebudget op organische AI-zichtbaarheid, en stuur je op een cijfer dat je zelf hebt gekocht.
Meten is niet hetzelfde als sturen
Tot slot een nuance die we liever vooraf benoemen. AI-zichtbaarheid meten geeft een richting, geen exacte waarheid, en een hoge score is geen doel op zich. Het gaat erom of AI-zichtbaarheid uiteindelijk klanten en omzet oplevert.
Bovendien staat de meting nooit stil. Crawlers worden aangepast, modellen worden opnieuw getraind, bronrankings verschuiven. Een meetrapport van drie maanden geleden beschrijft een situatie die er niet meer is. Daarom werkt dit alleen als lus: meten, prioriteren, handelen, opnieuw meten. Wie na de eerste meting stopt, heeft een momentopname gekocht.
We verkopen geen cijfers die we niet hard kunnen maken, en houden het bij wat we echt kunnen laten zien.
Aan de slag met AI-zichtbaarheid meten
Wil je weten of jouw merk in AI-antwoorden voorkomt, welke pagina’s AI-crawlers ophalen en wat dat oplevert? Bekijk het marketing dashboard, of lees onze aanpak op GEO optimalisatie.
Veelgestelde vragen
Kun je AI-zichtbaarheid precies meten?
Nee, niet volledig. Er is geen sluitend overzicht zoals Search Console voor SEO, want AI-antwoorden zijn persoonlijk en een deel van het verkeer komt binnen zonder bron-label. Je meet met vijf databronnen naast elkaar, en dat geeft een goede richting, geen exacte meetlat.
Wat zie je in serverlogs dat je nergens anders ziet?
Welke URL’s daadwerkelijk door een AI-crawler zijn opgehaald, hoe vaak, en door welke crawler. Prompttools werken met een steekproef en technische crawls zijn een momentopname. Een serverlog registreert wat er echt is gebeurd.
Wat is het verschil tussen GPTBot en ChatGPT-User?
GPTBot crawlt breed voor indexering en modeltraining. ChatGPT-User komt langs op het moment dat iemand een vraag stelt en het systeem je pagina bezoekt om een antwoord te vormen. Een hit van ChatGPT-User hangt dus samen met een concrete gebruikersvraag, een hit van GPTBot niet.
Wat is AI share of voice?
Share of voice is hoe vaak jouw merk in AI-antwoorden verschijnt ten opzichte van je concurrenten op dezelfde vragen. Het is een van de kernmaten om je AI-zichtbaarheid mee te benchmarken, en het komt uit een promptset, dus uit een steekproef.
Hoe zie ik verkeer uit ChatGPT en Perplexity in GA4?
Maak een eigen kanaalgroep of splits je verkeer uit op bron, zodat sessies met bron chatgpt of perplexity apart verschijnen. Let op dat GA4 alleen de zichtbare verwijzingen ziet; veel AI-verkeer blijft ongelabeld.
Wat is dark AI traffic?
Dat is AI-verkeer dat binnenkomt zonder bron-label, bijvoorbeeld via AI Overviews, Gemini, ChatGPT op mobiel of zero-click-antwoorden. Het verdwijnt in je bestaande kanalen, waardoor je AI-verkeer vaak onderschat.
Moet je AI-verkeer splitsen in betaald en organisch?
Ja. Betaald AI-verkeer, bijvoorbeeld uit ChatGPT Ads, herken je aan de UTM-parameters. Zonder die splitsing tel je advertentieverkeer mee als organische AI-zichtbaarheid en stuur je op een cijfer dat je zelf hebt ingekocht.